Linear Regression
إزاي الموديل يتعلم سعر العربية من الداتا؟
هنمشي ورا السبورة خطوة خطوة، بنفس مثال المحاضرة: Car Pricing.
كل جزء ليه نسختين: نسخة منظمة تذاكر منها، والسبورة الأصلية زي ما اتكتبت.
1الفكرة: معادلة خط
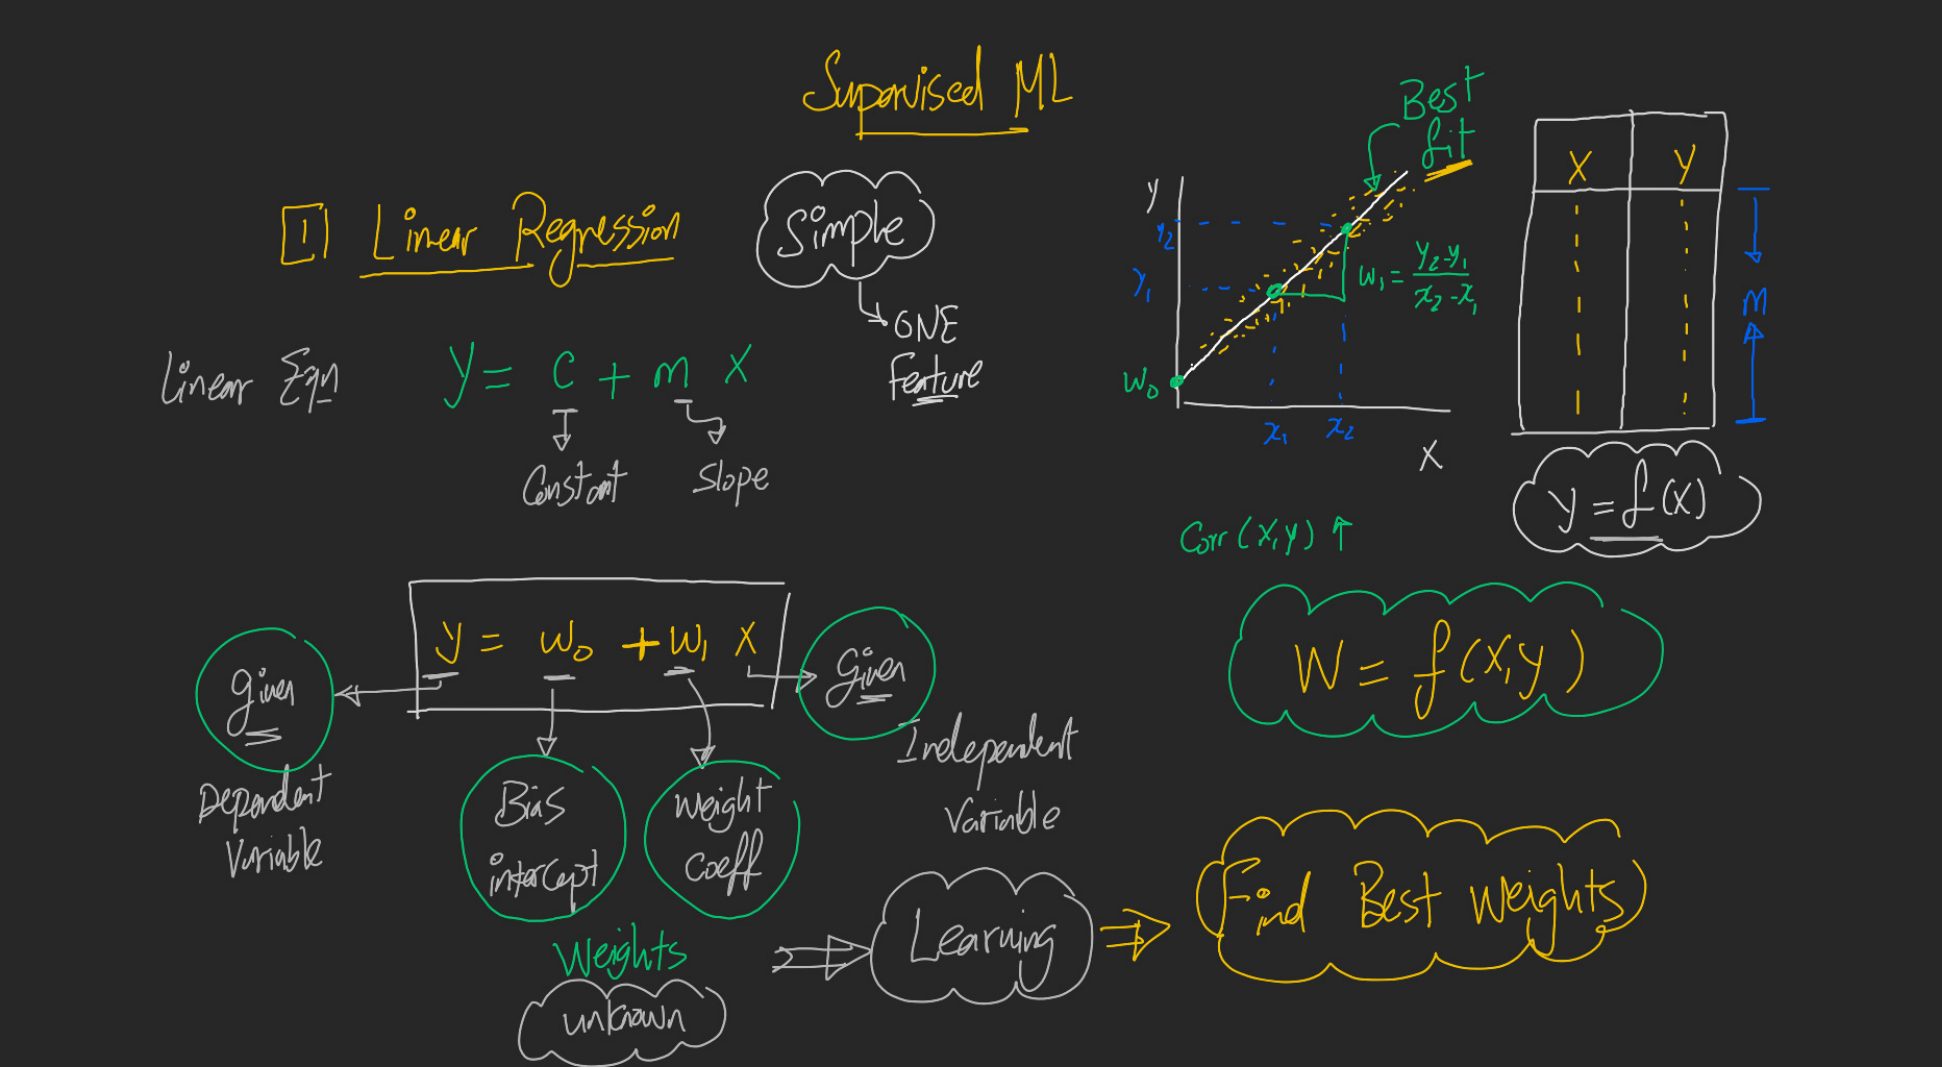
من الرياضة احنا عارفين معادلة الخط: \(y = c + m\,x\)
الـ c هو الـ constant، والـ m هو الـ slope.
في الـ Machine Learning بنكتب نفس المعادلة بأسامي تانية:
Given
Given
Unknown
Unknown
الـ x والـ y موجودين معانا في الداتا (جدول فيه m record).
المجهول الوحيد هو الـ weights.
يعني الموديل كله عبارة عن دالة في الداتا:
وكلمة Simple معناها إن عندنا feature واحدة بس.
وكل ما الـ correlation بين x و y يبقى أعلى، الخط يمثّل الداتا أحسن.
والتعلّم هنا معناه حاجة واحدة:
2Vectorized Form والـ Normal Equation
عندنا m records.
عشان نكتب المعادلة بشكل matrix، بنضيف عمود \(x_0 = 1\) لكل الـ records.
وبكده الـ bias بيدخل في الضرب زي أي weight:
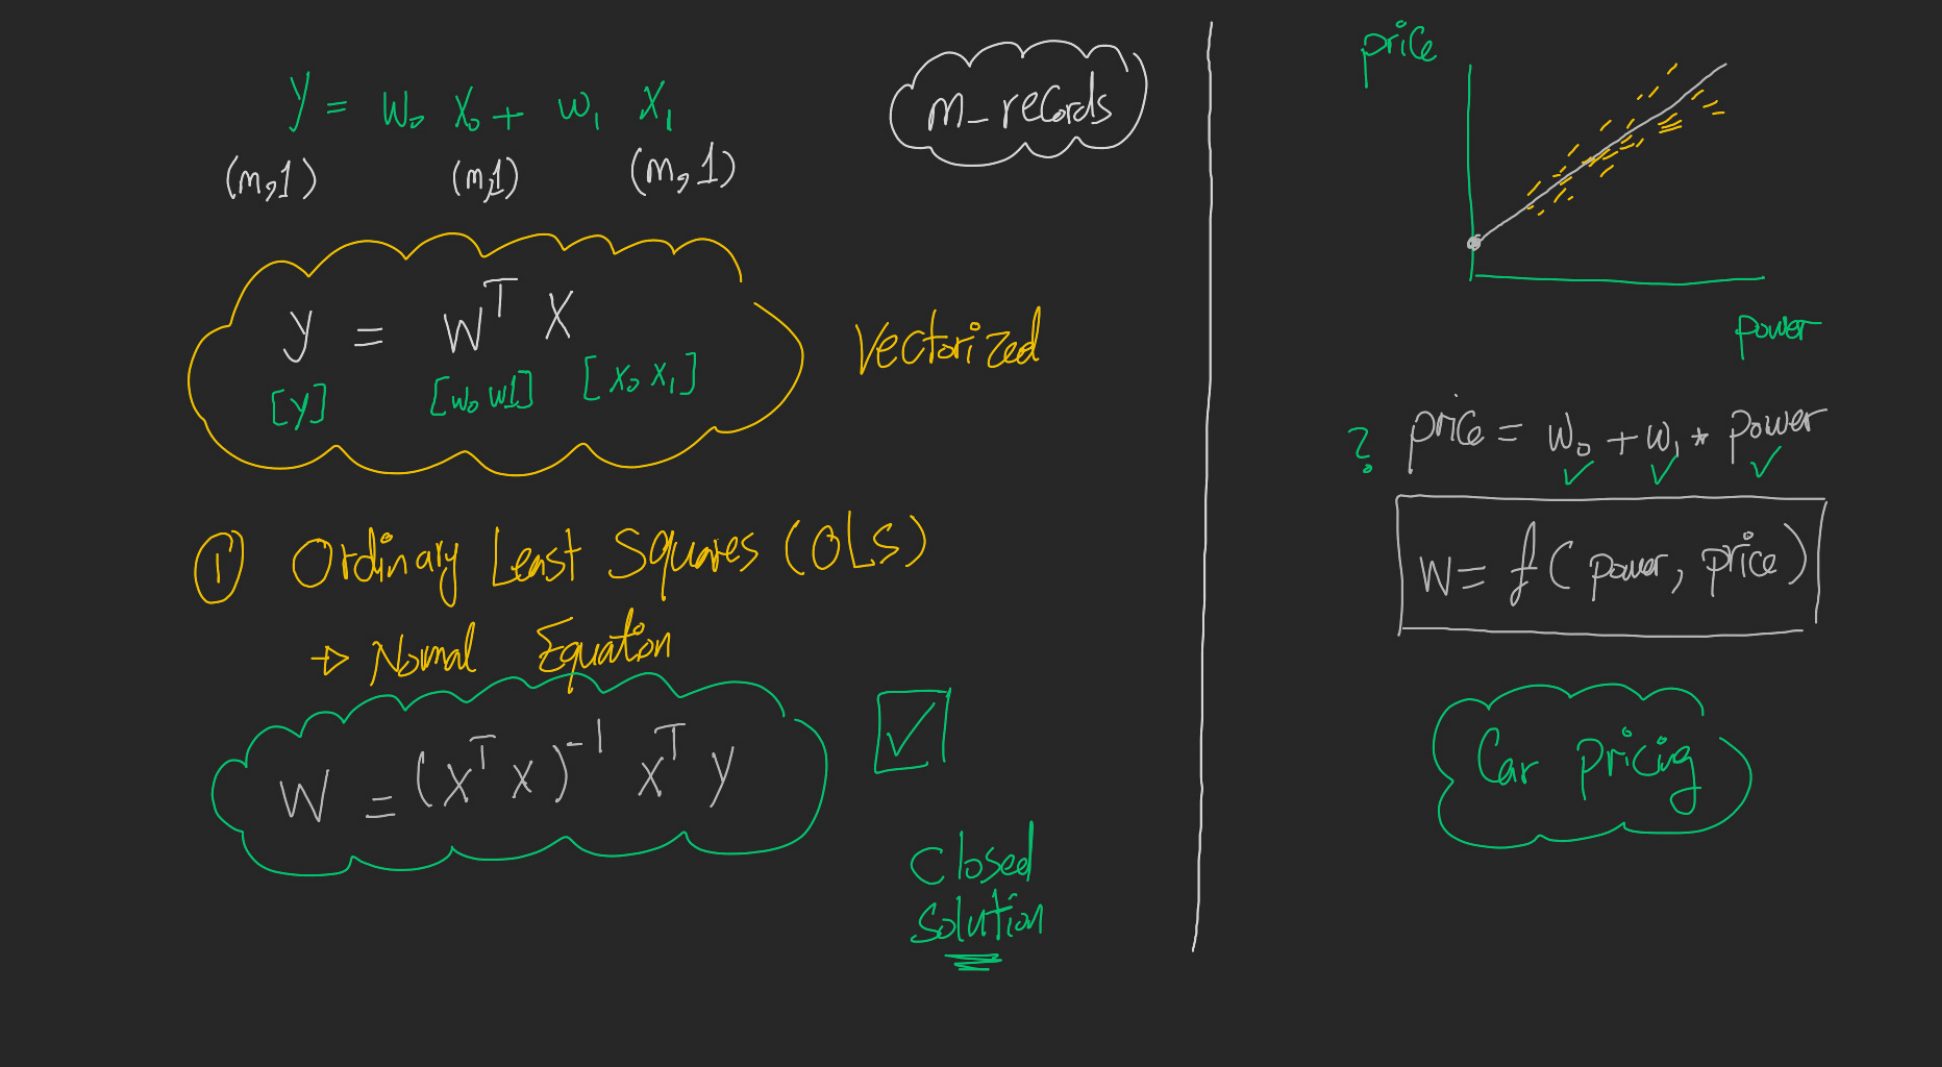
ولو جمعنا الـ weights في vector واحد \(\mathbf{w} = [w_0,\ w_1]\)،
والـ features في matrix واحدة \(X = [x_0,\ x_1]\):
① Ordinary Least Squares (OLS)
بتدينا الـ weights مباشرة، بمعادلة اسمها Normal Equation:
ده Closed Solution.
حسبة واحدة ونطلع بالـ weights، من غير iterations ولا learning rate.
وفي مثال Car Pricing: \(\text{price} = w_0 + w_1 \cdot \text{power}\)
الـ price والـ power معروفين ✓
يبقى \(W = f(\text{power},\ \text{price})\).
➕ إضافة: منين جت الـ Normal Equation؟
عايزين أقل error، يعني نقلل \(J(\mathbf w) = \lVert \mathbf y - X\mathbf w \rVert^2\).
ناخد الـ gradient ونساويه بصفر:
الحل ده محتاج إن \(X^\top X\) تكون invertible.
لو فيه features متكررة أو مرتبطة ببعض جامد (multicollinearity)، الحسبة بتبوظ.
وعشان كده LinearRegression في sklearn بتحلها بالـ SVD (pseudo-inverse)، مش بالـ inverse المباشر.
3Find Best Weights: الـ Cost Function
يعني إيه "أحسن" weights؟
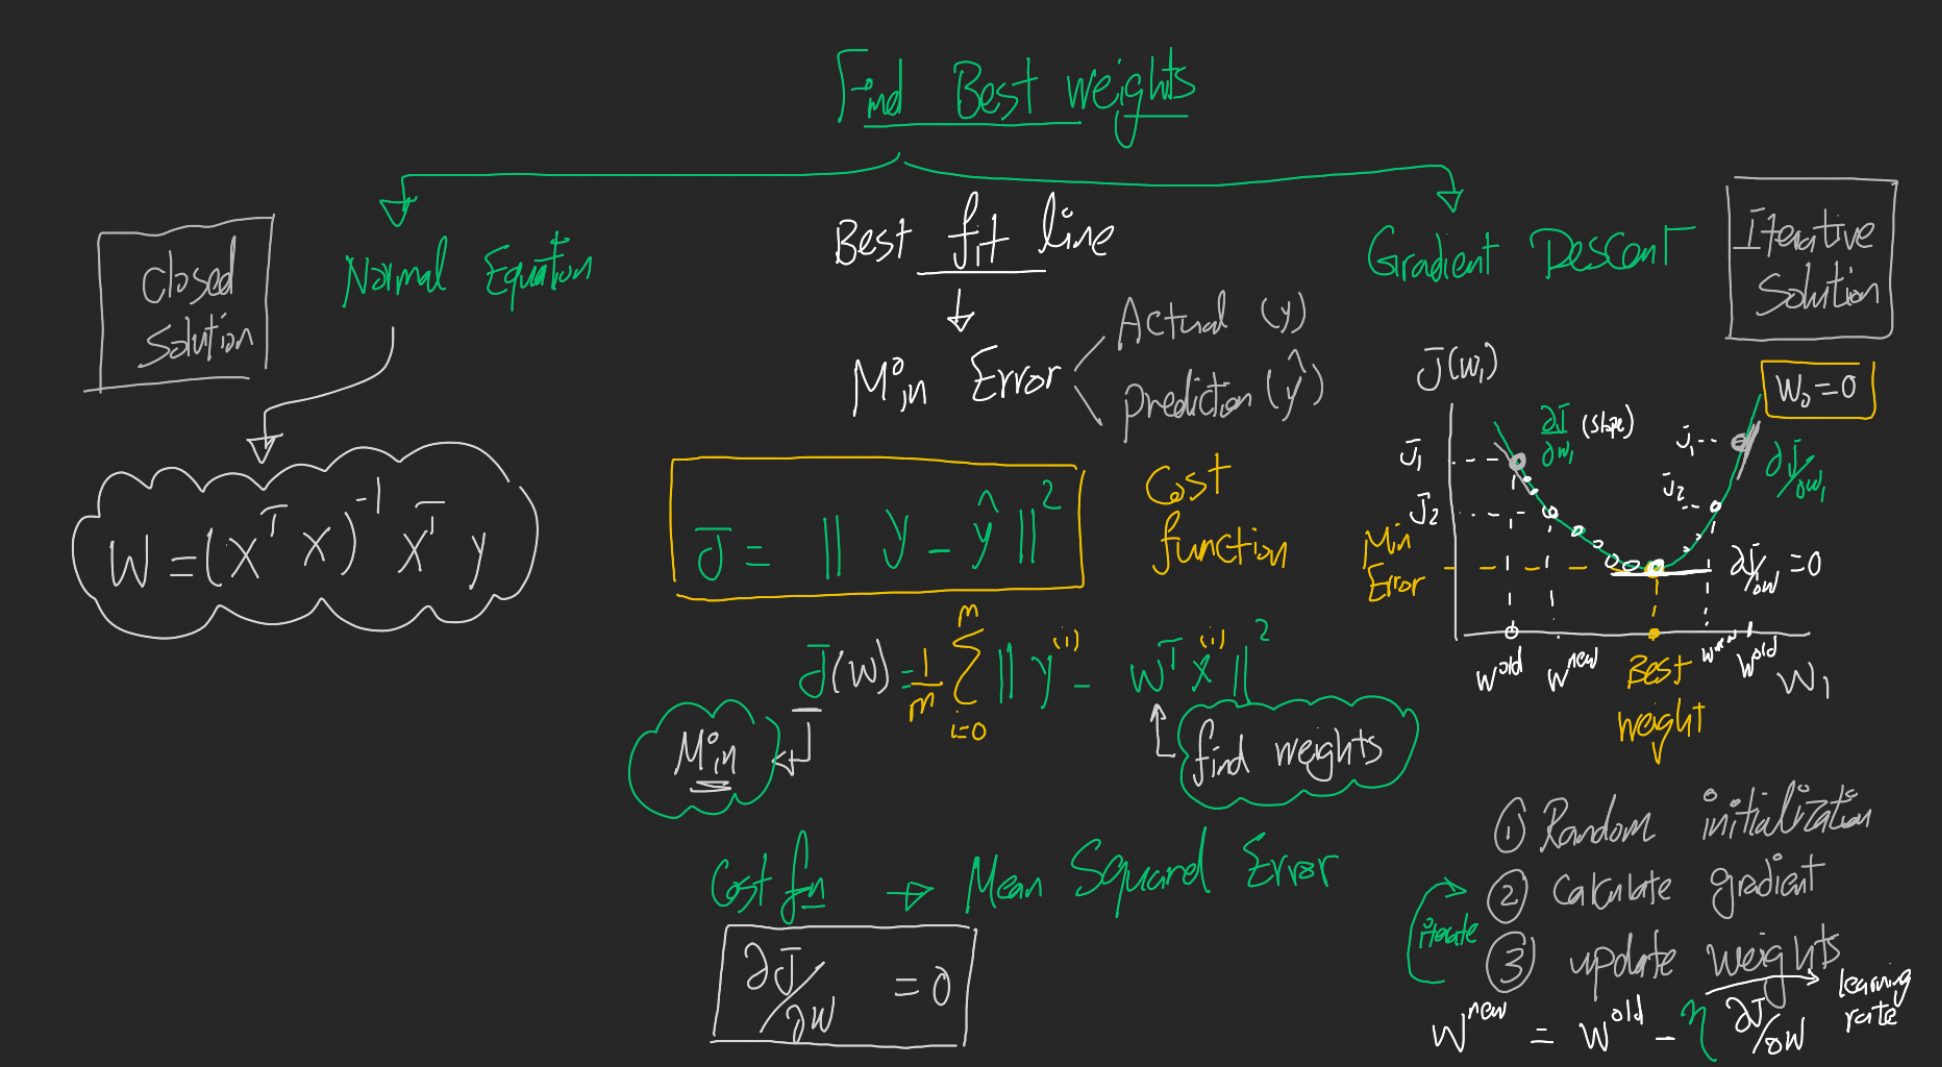
يعني Best fit line: الخط اللي بيدينا Min Error بين الـ Actual \((y)\) والـ Prediction \((\hat y)\).
عشان كده بنعرّف Cost Function:
الـ Cost function دي اسمها Mean Squared Error.
والـ \(\frac12\) اللي قدامها مش بتغيّر مكان الـ min، هي بس بتسهّل التفاضل.
هدفنا نلاقي الـ weights اللي تخلّي \(J\) أقل حاجة (Min J).
وفيه طريقين:
Normal Equation
نحل \(\dfrac{\partial J}{\partial \mathbf w} = 0\) مرة واحدة.
ونطلع بالحل: \(\mathbf w = (X^\top X)^{-1}X^\top \mathbf y\)
Gradient Descent
نبدأ من weights عشوائية.
وننزل على منحنى \(J\) خطوة خطوة، لحد ما نوصل للـ Min Error.
4Gradient Descent خطوة بخطوة
عندنا weights اتنين، يبقى الـ cost دالة في الاتنين:
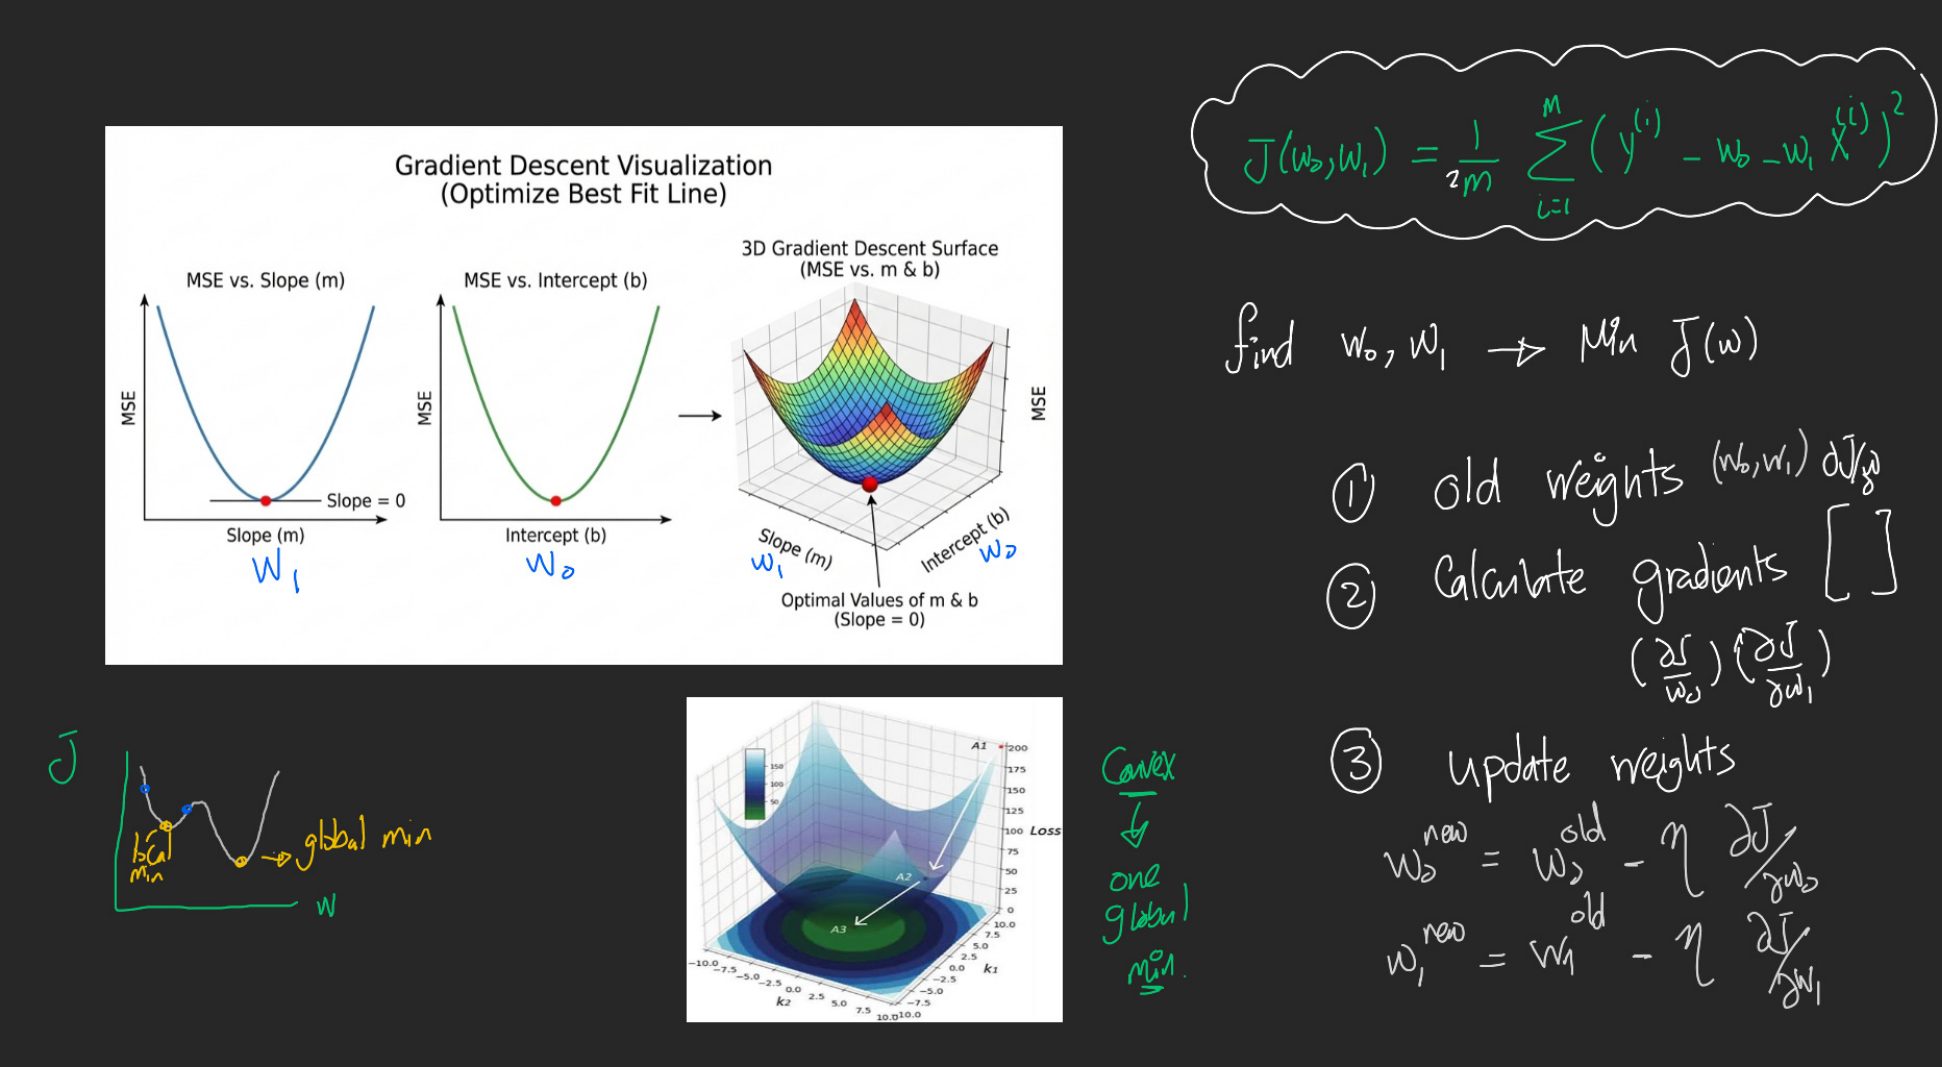
\[ J(w_0, w_1) = \frac{1}{2m}\sum_{i=1}^{m}\left(y^{(i)} - w_0 - w_1 x^{(i)}\right)^2 \]وعايزين: find w₀, w₁ → Min J(w)
الخطوات:
- Random initialization: نبدأ بـ weights قديمة \((w_0, w_1)\) أي قيم.
- Calculate gradients: نحسب \(\dfrac{\partial J}{\partial w_0}\) و \(\dfrac{\partial J}{\partial w_1}\).
يعني الـ slope عند النقطة اللي احنا فيها. - Update weights: \( w_0^{new} = w_0^{old} - \eta\,\dfrac{\partial J}{\partial w_0} \)، \( w_1^{new} = w_1^{old} - \eta\,\dfrac{\partial J}{\partial w_1} \)
والـ \(\eta\) هو الـ learning rate.
ونفضل نكرر (iterate) خطوة 2 و 3.
ليه السالب؟
لو الـ slope موجب، يبقى احنا على يمين الـ min، فبنقلل الـ w.
ولو سالب، يبقى احنا على شماله، فبنزوّدها.
وعند الـ min الـ slope بيبقى صفر \(\left(\frac{\partial J}{\partial w}=0\right)\)، والـ weights بتبطّل تتحرك.
والخبر الحلو: الـ \(J\) في الـ Linear Regression شكلها طبق (Convex).
يعني فيها one global min بس، ومفيش local min ممكن نقع فيه.
➕ إضافة: الـ gradients بالتفصيل
لما نفاضل \(J\)، الـ 2 اللي نازلة من التربيع بتلغي الـ \(\frac12\).
ونطلع بـ:
دي بالظبط الحسبة اللي شغالة في الأداة اللي تحت.
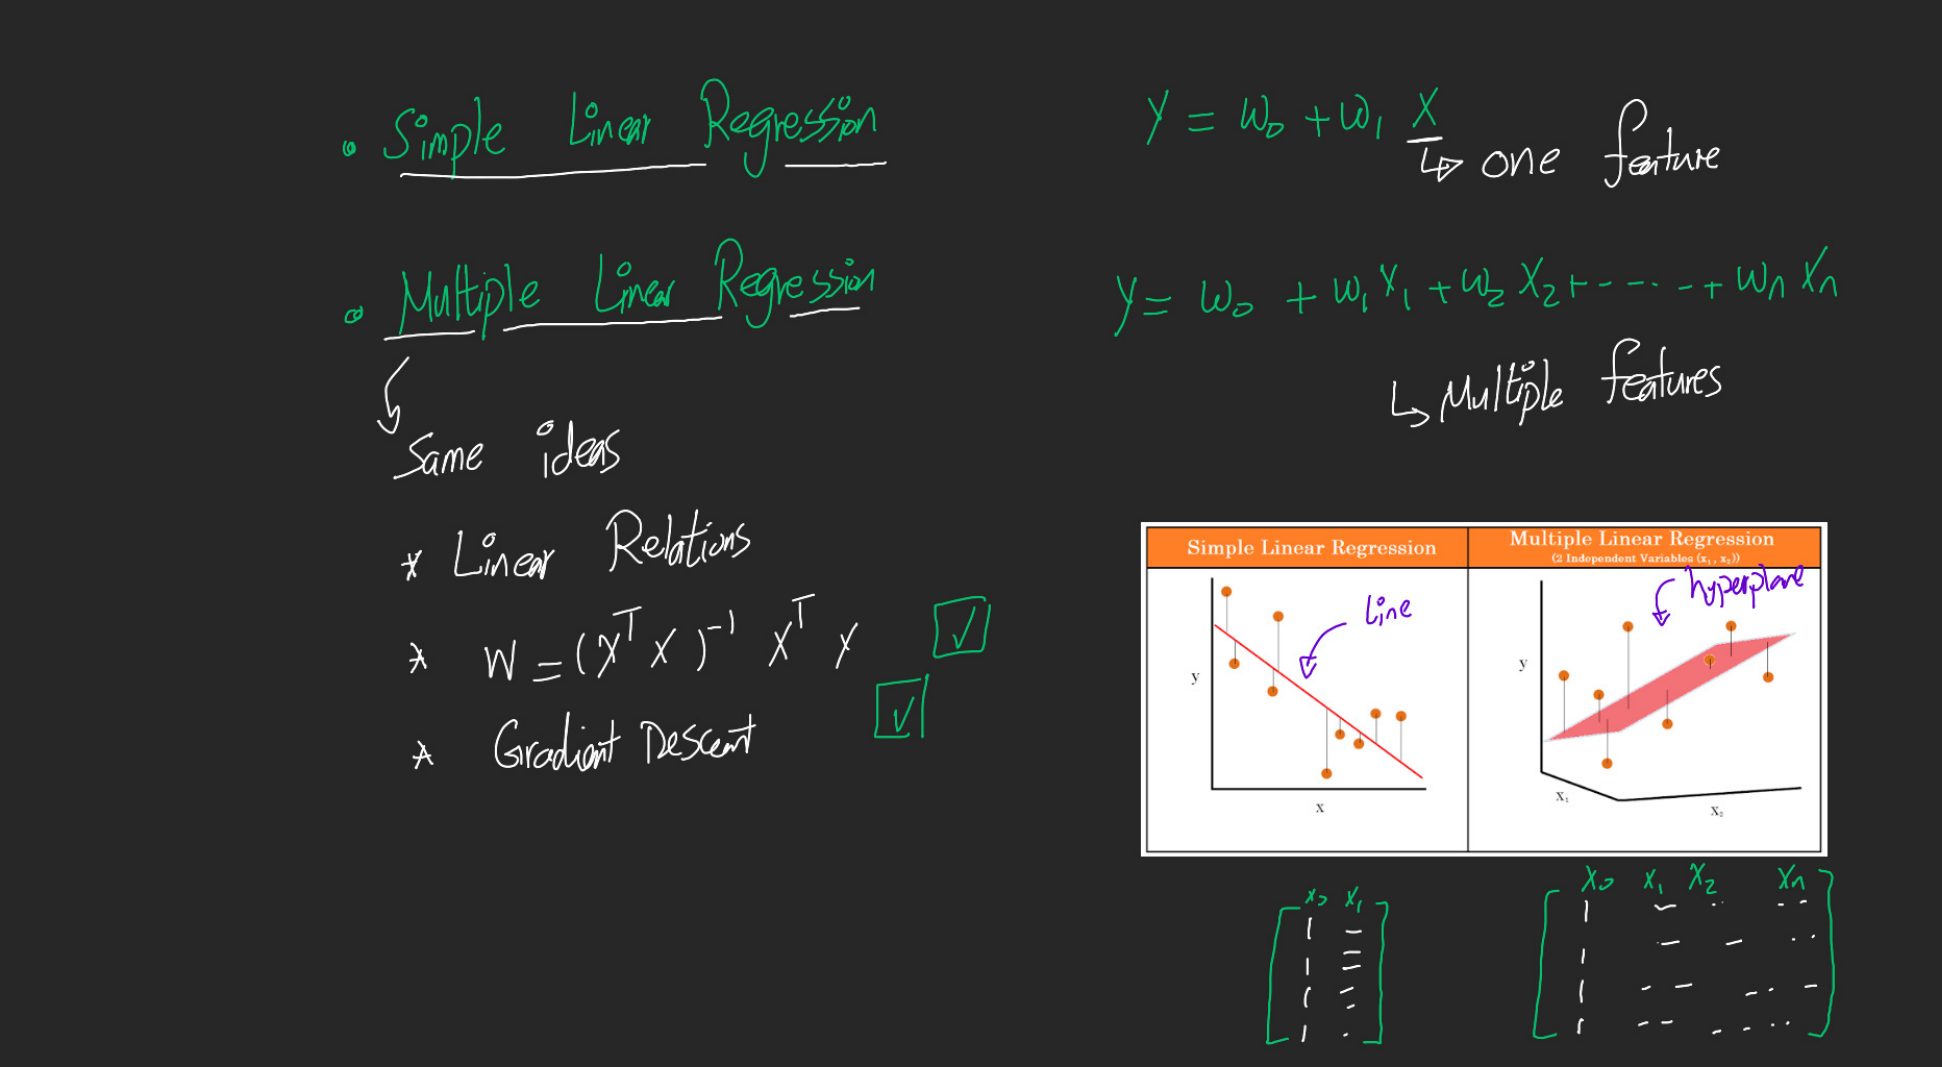
5Simple vs Multiple Linear Regression
Simple Linear Regression
الـ \(X\) شكلها \((m, 2)\): عمود \(x_0\) كله 1، وعمود \(x_1\).
Multiple Linear Regression
الـ \(X\) شكلها \((m, n+1)\): عمود \(x_0\)، و n features.
Same ideas: لسه بنفترض علاقة Linear.
والـ Normal Equation شغالة ✓، والـ Gradient Descent شغال ✓.
الفرق الوحيد إن الـ \(\mathbf w\) بقى فيها weights أكتر.
6OLS ولا Gradient Descent؟
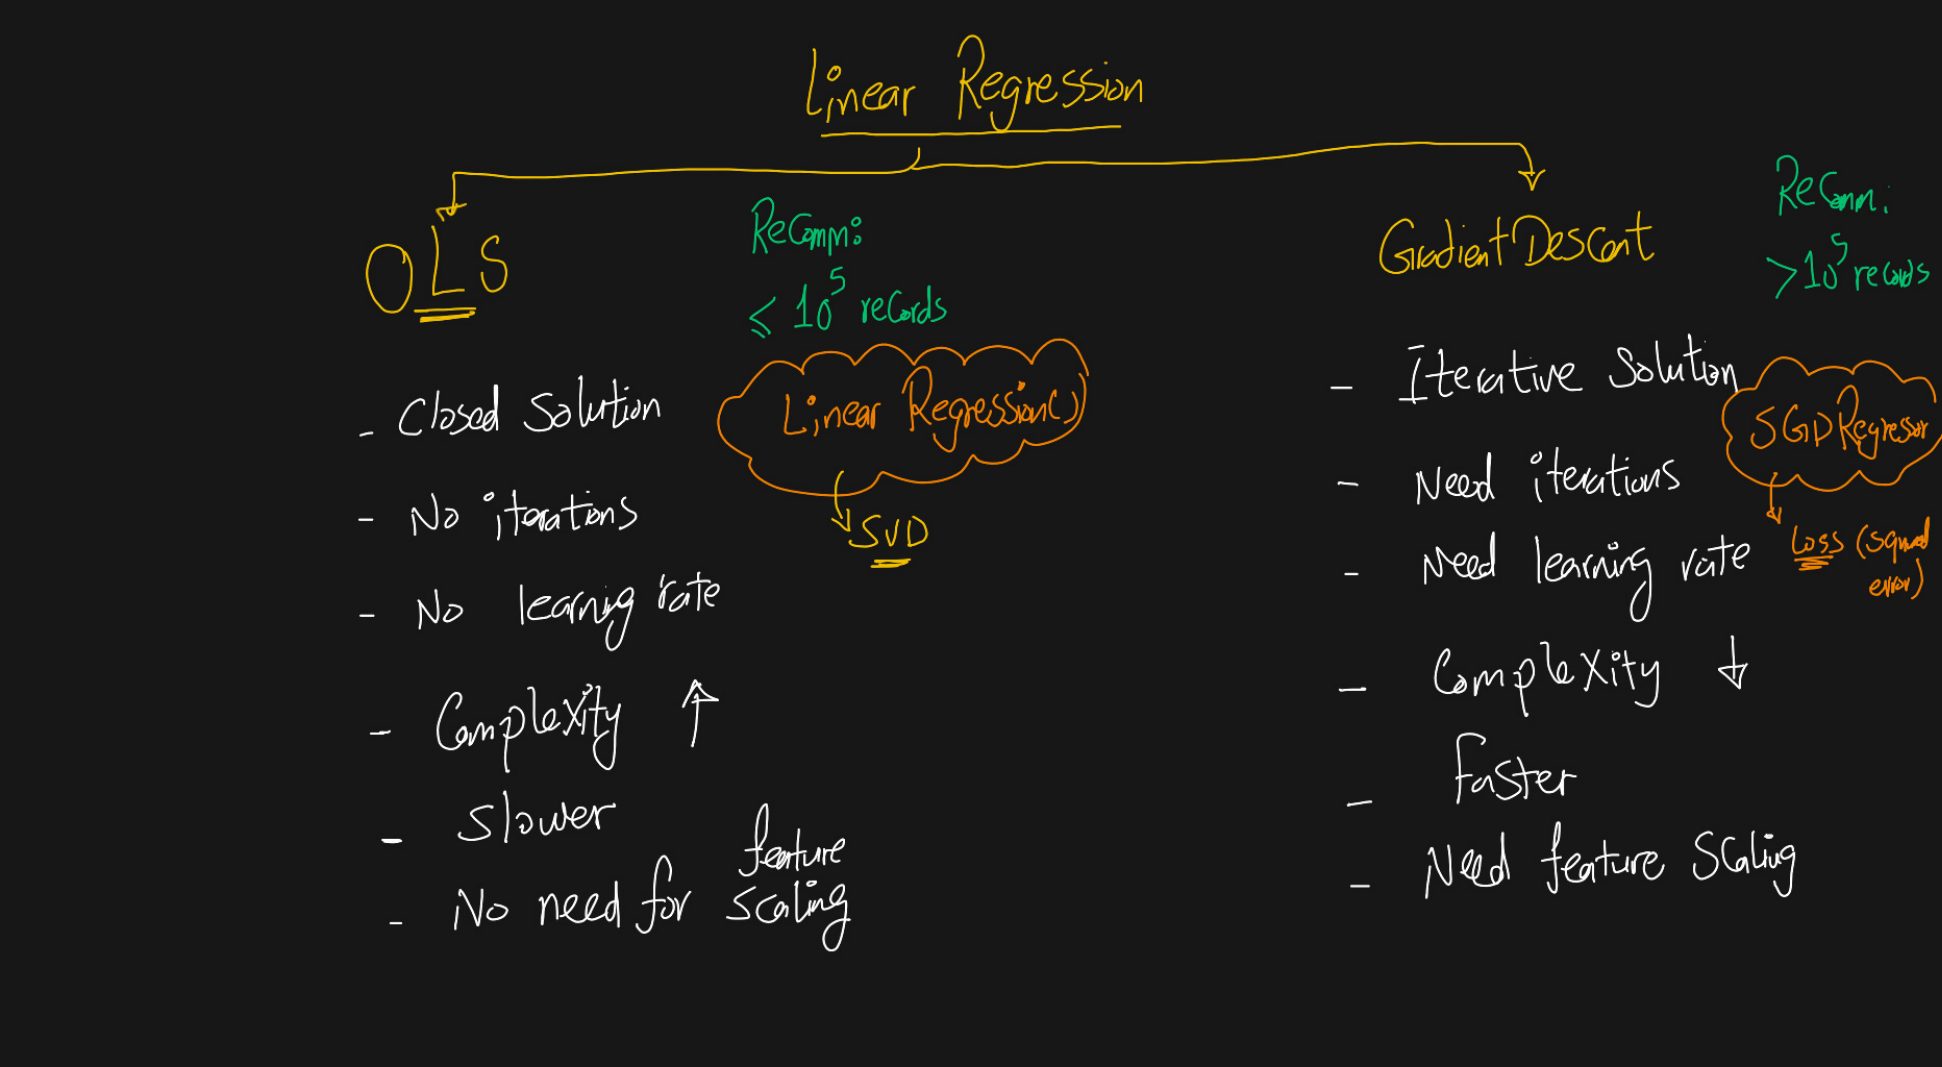
| OLS (Normal Equation) | Gradient Descent | |
|---|---|---|
| نوع الحل | Closed Solution | Iterative Solution |
| Iterations | No iterations | Need iterations |
| Learning rate | No learning rate | Need learning rate |
| Complexity | أعلى ↑ (بتكبر بسرعة مع عدد الـ features) | أقل ↓ (أسرع مع الداتا الكبيرة) |
| Feature scaling | مش محتاج | محتاج |
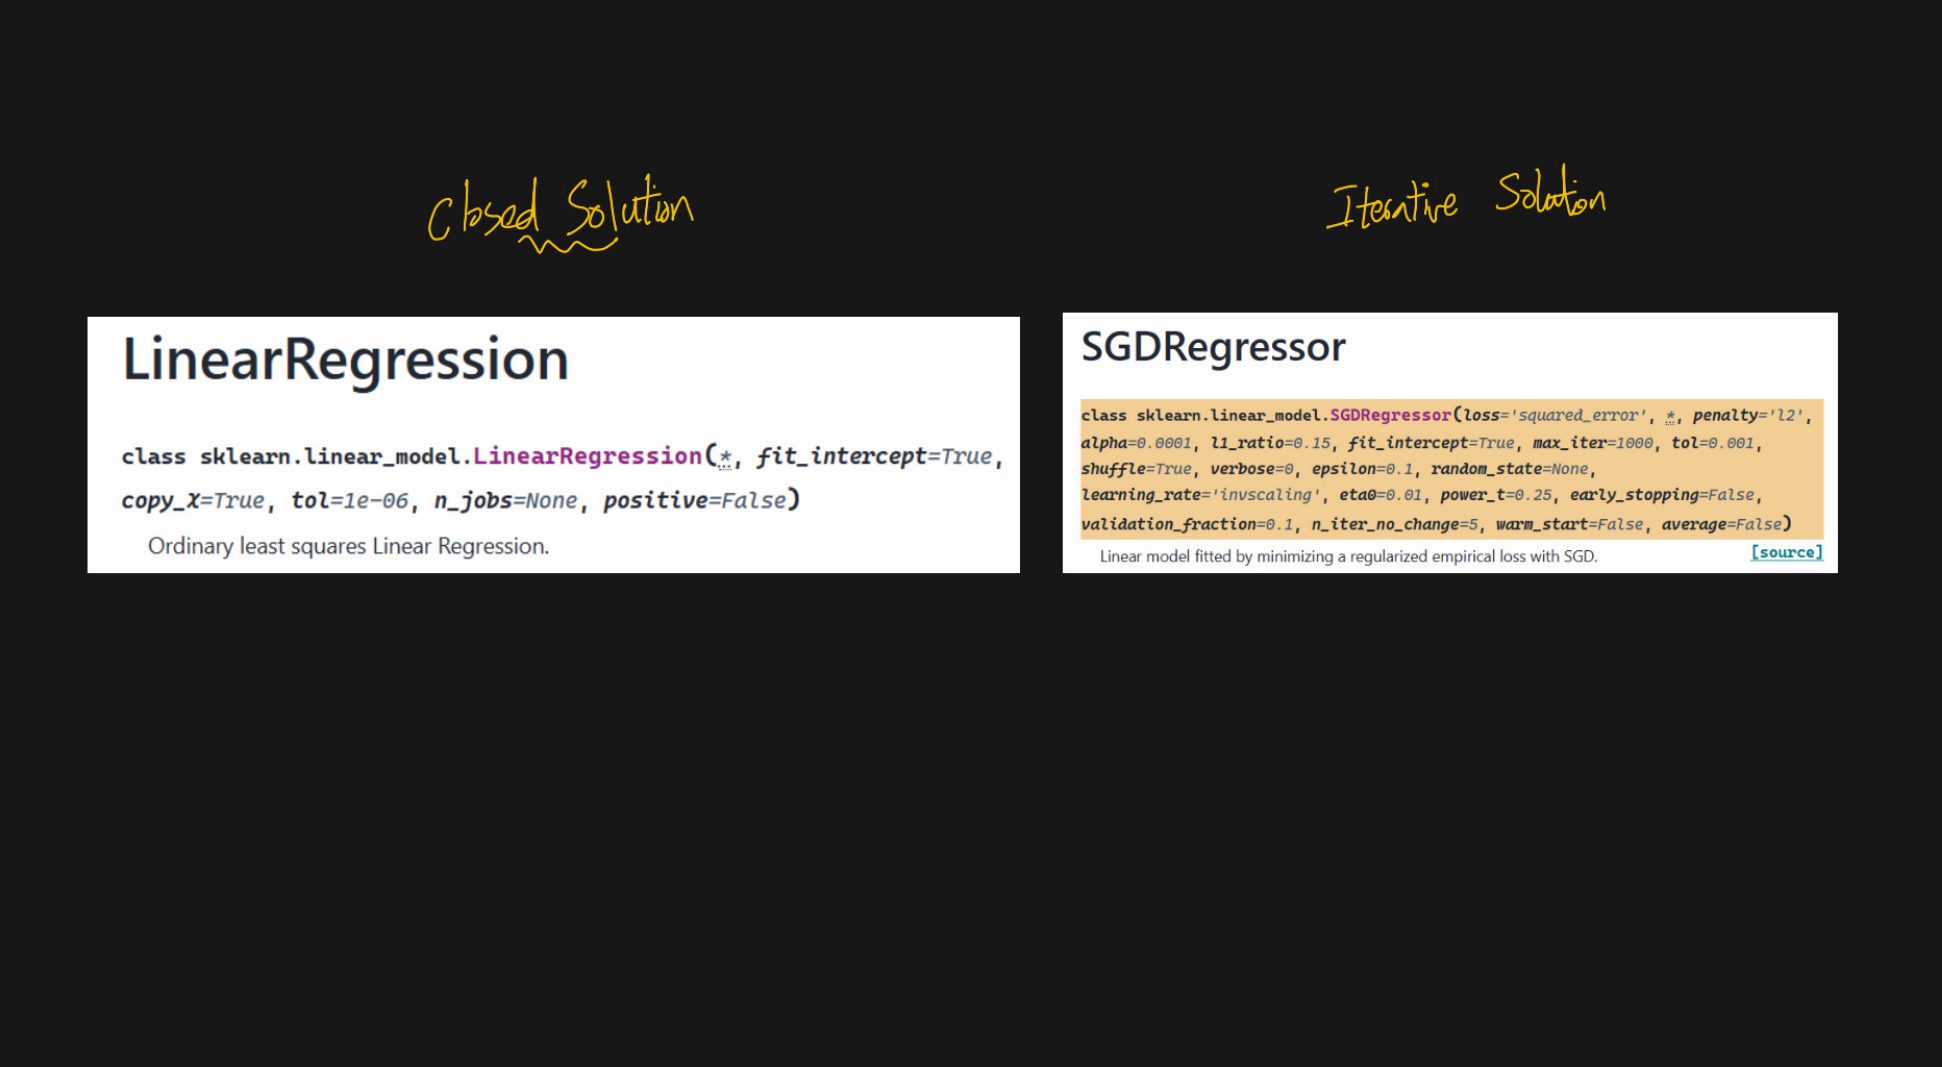
| في sklearn | LinearRegression() (بتستخدم SVD) | SGDRegressor (loss = squared error) |
| Recommendation | لحد حوالي \(10^5\) records، والـ features مش كتير | داتا ضخمة جدًا (أكتر من \(10^5\) records)، أو features كتير جدًا |
الـ \(10^5\) رقم تقريبي، مش قاعدة ثابتة.
تكلفة الـ OLS بتكبر بسرعة مع عدد الـ features، أكتر من عدد الـ records.
فلو الداتا ضخمة جدًا، أو الـ features كتير جدًا، روح للـ Gradient Descent.
from sklearn.linear_model import LinearRegression, SGDRegressor
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

# Closed solution (OLS)
ols = LinearRegression()
ols.fit(X_train, y_train)

# Iterative solution: محتاج scaling قبله
sgd = make_pipeline(StandardScaler(),
                    SGDRegressor(loss="squared_error", eta0=0.01, max_iter=1000))
sgd.fit(X_train, y_train)
SGDRegressor بيضيف regularization صغير by default (penalty="l2", alpha=0.0001).عشان كده الـ weights بتاعته ممكن تطلع مختلفة شوية عن
LinearRegression.هنتكلم عن الـ regularization (Ridge / Lasso) بعدين.
7Regression Evaluation
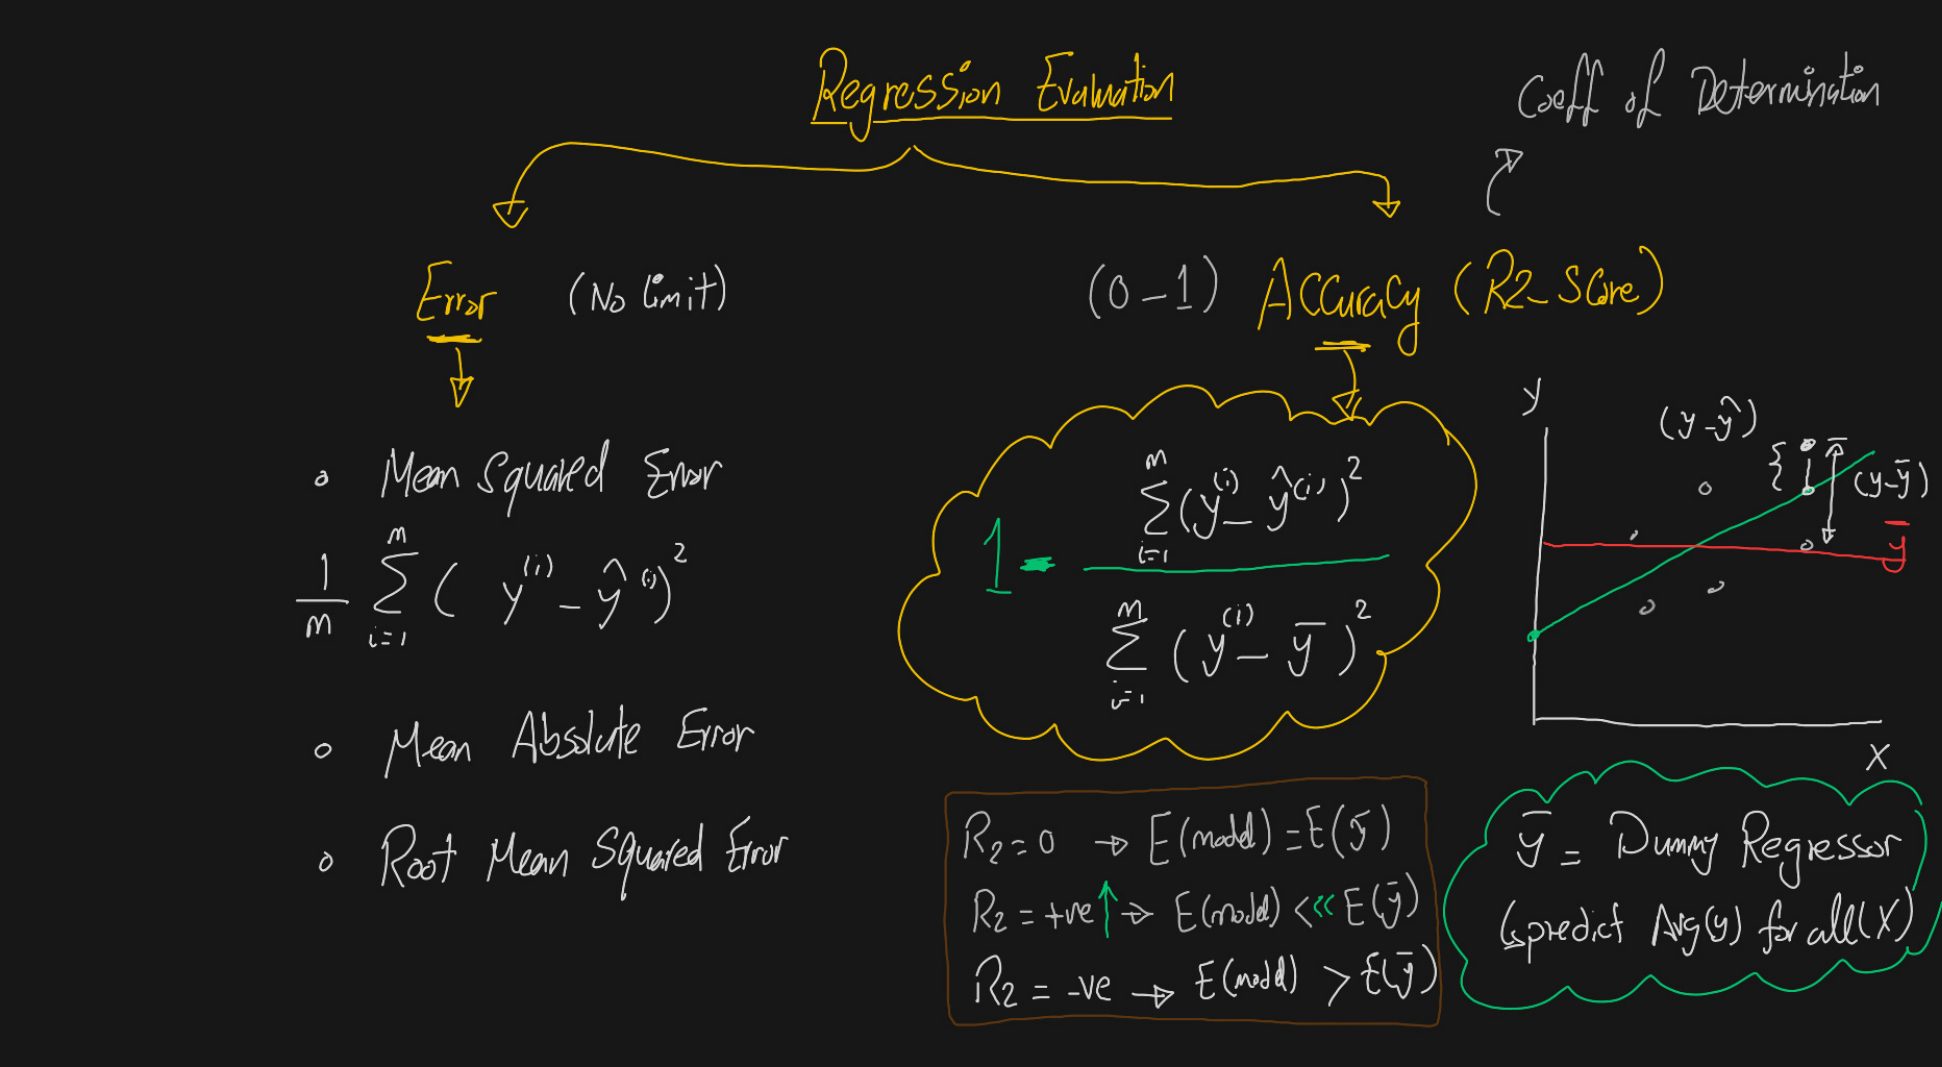
Error
Mean Squared Error \[ \text{MSE} = \frac1m\sum_{i=1}^{m}\left(y^{(i)}-\hat y^{(i)}\right)^2 \]
Mean Absolute Error \[ \text{MAE} = \frac1m\sum_{i=1}^{m}\left|y^{(i)}-\hat y^{(i)}\right| \]
Root Mean Squared Error \[ \text{RMSE} = \sqrt{\text{MSE}} \]
R² Score
بنقراها زي الـ Accuracy: الطبيعي إنها بين 0 و 1.
وكل ما تقرب من 1 كل ما الموديل أحسن، والـ 1 معناها 100%.
بس ممكن تطلع سالبة، لو الموديل أسوأ من الـ Dummy Regressor.
والـ Dummy Regressor هو اللي في المقام: موديل بسيط بيتوقع المتوسط \(\bar y\) لكل الـ X.
فالـ R² بتقارن الموديل بتاعنا بيه:
| \(R^2 = 0\) | E(model) = E(ȳ): مش أحسن من المتوسط |
| \(R^2\) +ve ↑ | E(model) ≪ E(ȳ): الموديل أحسن بكتير |
| \(R^2\) −ve | E(model) > E(ȳ): الموديل أسوأ من المتوسط |
الـ RMSE بيعاقب الأخطاء الكبيرة أكتر، بسبب التربيع.
فلو غلطة كبيرة في سعر عربية واحدة تفرق معاك، بص على الـ RMSE.
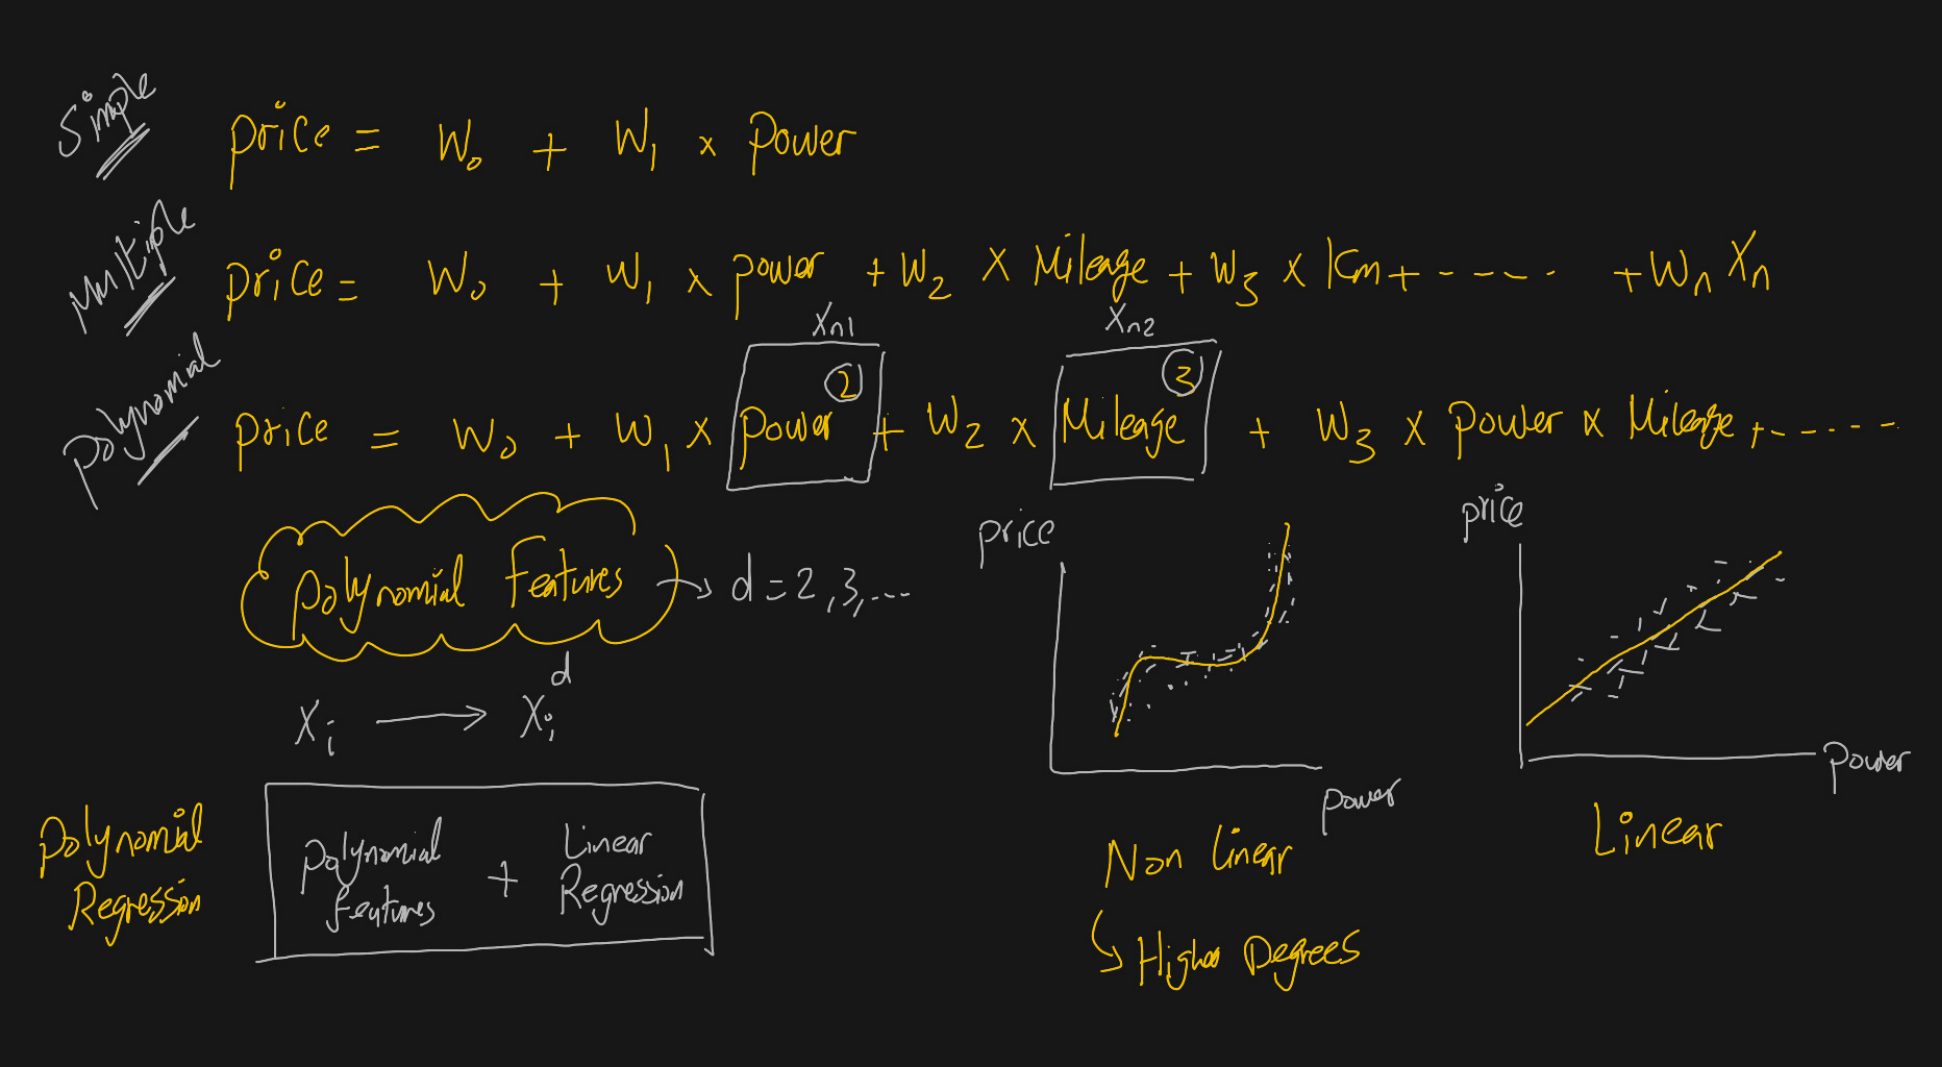
8Polynomial Regression
| Simple | \(\text{price} = w_0 + w_1 \times \text{power}\) |
| Multiple | \(\text{price} = w_0 + w_1 \times \text{power} + w_2 \times \text{mileage} + w_3 \times \text{km} + \dots + w_nx_n\) |
| Polynomial | \(\text{price} = w_0 + w_1 \times \text{power}^2 + w_2 \times \text{mileage}^3 + w_3 \times \text{power}\times\text{mileage} + \dots\) |
لو العلاقة بين الـ power والسعر مش خط مستقيم (Non linear)، بنعمل Polynomial Features.
كل feature بنرفعها لأس \(d = 2, 3, \dots\)، يعني \(x_i \rightarrow x_i^{\,d}\).
وكمان بنضرب الـ features في بعض.
لأن المنحنى بقى عنده حرية أكتر يعدّي على كل النقط.
بس عند حد معين بيبدأ يحفظ الداتا بدل ما يفهمها، والـ test error يرجع يعلى.
ده اسمه Overfitting.
وعكسه لما الموديل أبسط من الداتا (زي خط مستقيم على داتا شكلها S)، واسمه Underfitting.
فاحنا بنختار الـ degree على أساس الـ test (أو الـ validation)، مش الـ train.
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LinearRegression

model = make_pipeline(PolynomialFeatures(degree=3), StandardScaler(), LinearRegression())
model.fit(X_train, y_train)
print(model.score(X_test, y_test))   # R² على الـ test
9اختبر نفسك
8 أسئلة سريعة.
اختار إجابة، وهتلاقي الشرح ظهر تحتها.
10الخلاصة في كارت واحد
الموديل
\(\hat{\mathbf y} = X\mathbf w\)Learning ⇒ Find Best Weights
Cost Function (MSE)
\(J(\mathbf w)=\frac{1}{2m}\sum (y^{(i)}-\hat y^{(i)})^2\)OLS / Normal Equation
\(\mathbf w=(X^\top X)^{-1}X^\top\mathbf y\)Closed · No scaling ·
LinearRegressionGradient Descent
\(w^{new}=w^{old}-\eta\,\frac{\partial J}{\partial w}\)Iterative · Needs scaling ·
SGDRegressorEvaluation
MSE · MAE · RMSE\(R^2 = 1-\frac{SSE}{SST}\)، مقارنة بالـ Dummy \(\bar y\)
Polynomial
Polynomial Features + Linear Regressionاختار الـ degree على الـ test